2026 年 11 月美国中期选举落幕之后,国内市场上很快出现了两种截然相反的声音。一种认为美国 AI 被 "叫停" 了,技术窗口正在向中国企业打开;另一种则渲染监管收紧、技术封锁加码,AI 赛道的风险在快速上升。
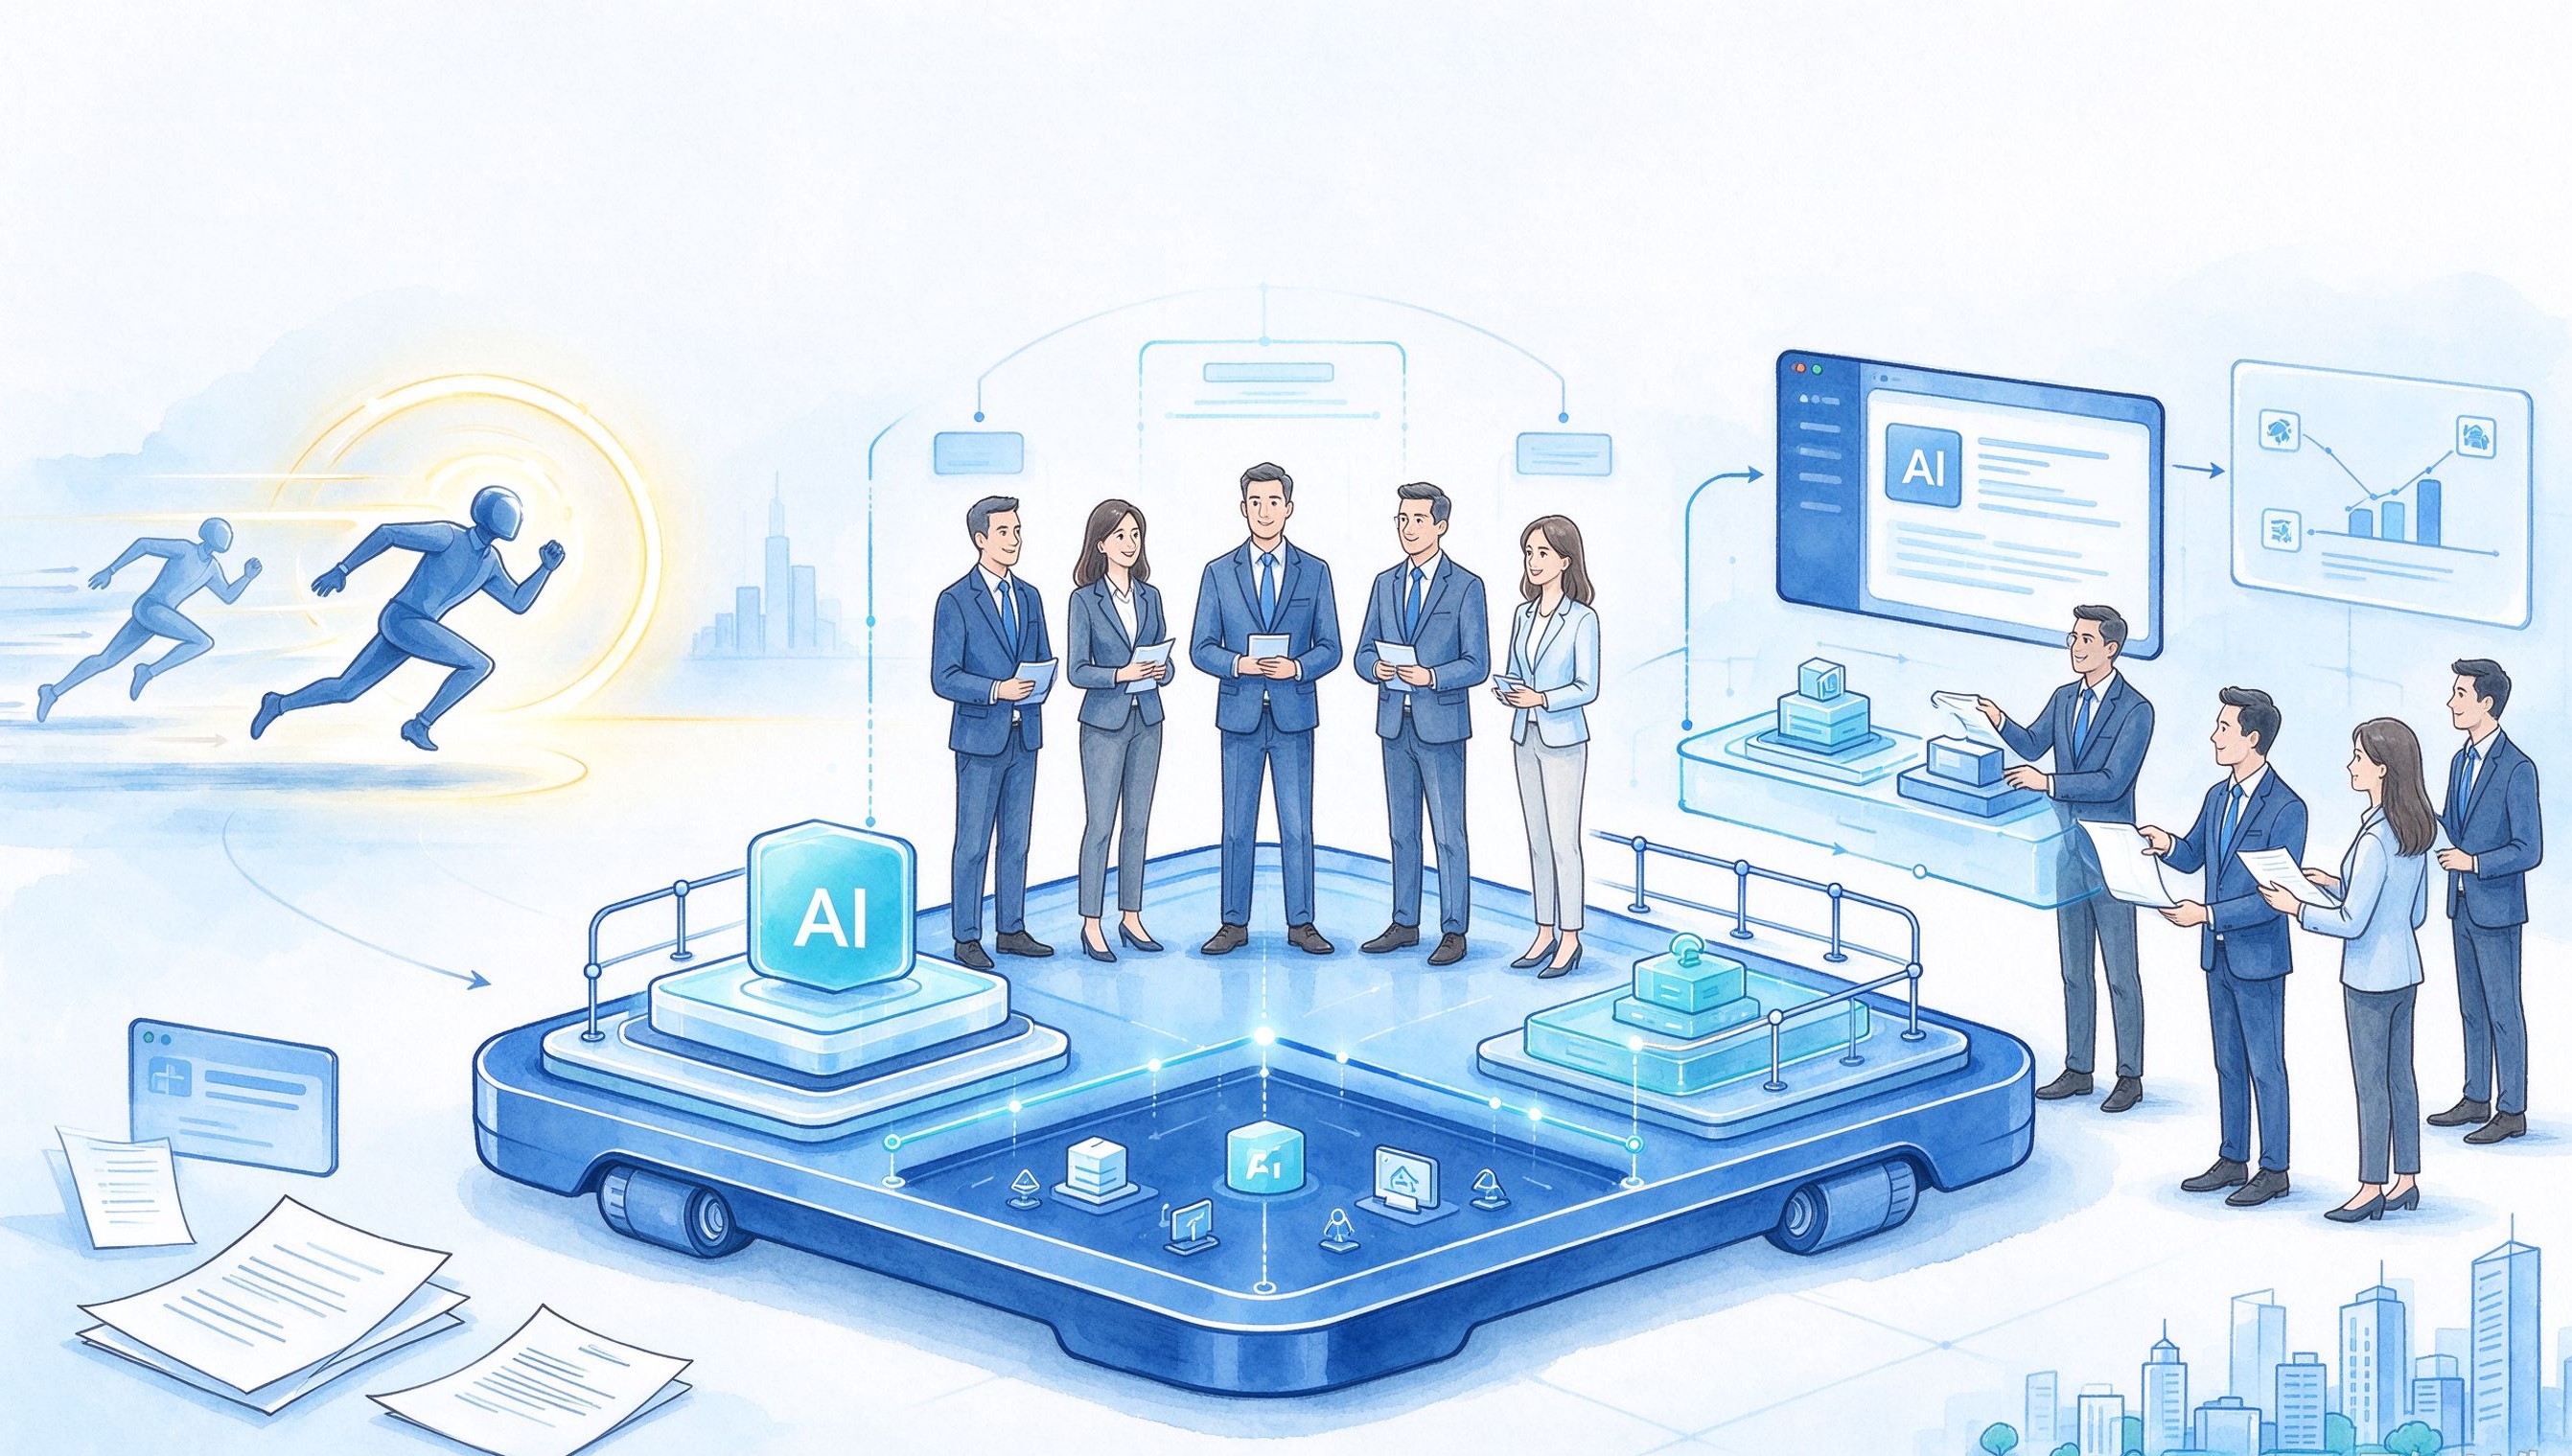
这两种解读都把复杂问题简化成了对错判断。回到公开信息本身看,这一轮变化更像是全球 AI 从 "先跑后治" 转向 "先证明安全再跑" 的一次节奏校准:政府主导、国会监督,规则开始前置,而不是技术本身失去了价值。
对中国企业而言,真正值得讨论的课题,也不是判断谁快谁慢、谁赢谁输,而是在规则不确定的环境里,如何把 AI 变成一项可审计、可替代、可退场的经营能力。这篇文章尝试把这件事放回技术演进与产业治理的脉络里,做一次冷静的拆解。
一、先看清楚:美国到底发生了什么
讨论之前,先把情绪和事实分开。目前公开信息里同时出现的,是三套不同层面的约束,它们经常被混在一起说成 "美国打压 AI",但性质并不相同。
物理层:算力供给的斜率在下修。 多个州对数据中心的审批节奏放慢,电力、水资源、环境影响和社区成本被重新纳入评估。过去那种快速拿地、快速上电、快速扩容的扩张方式,正在遇到现实约束,算力供给的增长曲线随之被下修。
制度层:前沿模型开始进入安全评估与审计框架。 相关法案草案进入听证程序,国会通过传票、安全评估等方式加强监督。方向不是禁止模型研发,而是要求高能力模型在发布前,先通过第三方视角的安全核验,把风险评估从企业内部自评,逐步推向外部可审计。
地缘层:出口管制走向刚性。 对华芯片、模型权重、远程算力相关的限制,正在从行政层面的灵活调整,逐步转向立法层面的约束,未来被行政令放松的空间变小。
需要澄清的是,这并不是 "立法禁止 AI",也不是某一方单纯反对技术本身。无论背后存在怎样的选举博弈或政策回归,落到产业层面的结果是一致的:AI 的成本曲线、技术可得性、合规边界,都在被重新定价。对国内企业来说,这更像是一个需要纳入规划前提的外部变量,而不是可以忽略的短期噪音。
二、为什么监管会在这个时点出现
理解这轮转向,只看选举结果是不够的。它背后有三层递进的原因。
表层,是选民层面的反弹。 数据中心耗电、耗水,自动化工具替代部分岗位,这些成本过去由公共资源和普通居民承担,却很少被计入模型公司的商业账。当外部性累积到一定程度,地方政治层面自然会出现约束诉求。
中层,是原有商业模式难以为继。 过去两年,不少模型公司的估值建立在叙事之上,而真实成本 —— 电网扩容、能源消耗、人才投入 —— 很大程度上被外部化给了公共部门和纳税人。当资本开始要求看到商业化回报,这种 "成本外置、收益内化" 的模式就很难持续。
深层,是 AI 的角色变了。 早期 AI 更像一款产品,成败由市场选择;而当它开始嵌入金融、医疗、制造、公共服务等关键环节,它实际上已经具备了基础设施的属性。参照金融、能源、通信这些行业的历史路径,一项技术一旦成为社会运转的底座,配套的监管框架、审计机制和责任边界就会随之建立。
从咨询视角看,技术红利往往分两个阶段:第一阶段比谁跑得快,先把工具用起来;第二阶段比谁经得起审计,谁的体系在规则变化下依然站得住。现在我们正在进入第二个阶段。
三、需要警惕的三种浅层反应
外部规则变化之后,企业内部很容易出现一些条件反射式的反应。它们看似方向明确,实则把复杂问题做了简化。
第一种:"美国放慢了,我们赶紧冲。" 这种判断忽略了两点:一是出口管制具有长臂效应,全球合规标准也在趋同,欧盟 AI Act 同样在持续收口;二是节奏可以由自己决定,但合规边界并不由自己决定。单纯把别人的减速当成自己的加速信号,风险很可能在出海、并购或数据跨境环节集中暴露。
第二种:"全力国产替代就解决了。" 硬件栈的替代是一条清晰的路径,但工程生态、工具链、验证体系、工程师经验的积累,无法靠单一替代完成。把复杂的技术自主问题压缩成 "换一批国产供应商",低估了体系性建设的难度。
第三种:"先不管,内部用起来再说。" 不少企业倾向于先把 AI 跑在内部场景,合规问题等到对外业务或跨境环节再处理。但合规成本往往是后置放大的:前期架构没有预留分级和留痕,后期补票的代价远高于前置设计。
四、可以重新评估的四个能力方向
以下内容更偏向观察框架,供不同阶段的企业结合自身业务判断,而非统一的行动清单。
第一,技术栈的可替换性。 过度绑定单一基座 —— 无论是闭源 API 还是单一硬件栈 —— 在规则波动下都会形成单点依赖。比较稳妥的思路,是在业务应用和模型之间留出一层抽象,使关键应用能够在开源、国产、海外模型之间切换;算力采用混合部署,核心数据留在本地,弹性任务部署在多云环境,关键链路保留退路。很多企业已经在做的 AI 技术债梳理和单点故障审计,本质上就是在评估这种退路是否存在。
第二,合规前置,而不是法务补票。 把出口管制涉及的芯片、权重、数据问题,作为产品设计的输入条件,而不是出海前的尽调环节才临时补做。对技术资产做分类分级:开源权重、闭源微调、自研基座、数据跨境,各自走不同的通道;在模型训练之前,先厘清基座来源、训练数据构成,以及可能触及的管制边界。这套动作越早进入研发流程,后期调整的摩擦就越小。
第三,从模型指标转向业务可审计指标。 除了 benchmark 上的跑分,更值得持续观察的是几项业务侧指标:决策可追溯 —— Agent 为什么给出这个推荐,依据是什么;数据可撤回 —— 样本和语料是否做了版本化管理;成本可解释 —— Token、算力、人力能否分摊到具体业务动作上。这与我们此前讨论的 "洞察可溯源" 是同一套逻辑:结论要能够回到原始依据,而不是停在一份漂亮的简报上。
第四,组织层面的韧性建设。 相比各业务线各自采购 Agent、各自搭建流程,总部层面统一模型采购白名单、提示词与知识库版本库、业务实验的对照机制,往往更能控制整体风险。此外,垂直行业的资深经验与外部专家网络,可以作为兜底存在 —— 当 AI 平滑掉反例、丢掉业务语境时,人的判断提供锚点。这也是市场研究与专家网络在 AI 时代价值重估的原因:它们补齐的,恰恰是模型自身难以生成的那部分业务语境。
五、几个行业的轻量参照
算力受限的前提下,优先从场景化小模型切入,工业数据在本地闭环,不必都涌向千亿级基座。先在具体工艺、质检、运维场景里验证价值,再讨论更大范围的平台化。
生成内容大量增加之后,"内容通胀" 会稀释传播效果,预算更值得留给一手消费者洞察和真实体验验证 —— 用户真实怎么想、怎么用,很难从批量生成的舆情摘要里读出来。
属于强监管行业,可直接按 "可审计 AI" 的标准来设计系统,留痕、可追溯、风险兜底在架构层面先行,不必等到监管要求落地再返工。
面向美、欧、东盟等不同市场,各自存在一套合规镜像,避免一套模型、一套数据流程在全球裸跑。区域规则的前置扫描,应当成为出海规划的常规环节。
结语
这轮变化本质上不是 AI 熄火,而是 AI 进入 "可审计增长" 的阶段。技术周期有起伏,治理框架在成型;对中国企业来说,真正的机会不在押注某一个模型或某一批算力,而在于构建规则变化之下依然站得住的组织韧性。
企业能够主动做的,是把外部的不确定性,转化为内部可以管理的能力:架构有退路,合规有前置,决策有依据,组织有兜底。剩下的,交给技术周期和市场验证。
本文参照公开报道整理,涉及中期选举与数据中心审批、前沿模型相关法案听证、出口管制与合规规则、欧盟 AI Act 等内容,仅作行业观察,不构成投资、法律或技术选型建议。